A gdyby tak rzucić wszystko i zastąpić respondentów botami?
Czyli zamiast przeprowadzać badania na prawdziwych ludziach, zastąpić je eksperymentami na AI? I na ich podstawie wyciągać wnioski o zachowaniach ludzi?
To już nie tylko eksperymenty rynkowe, ale i rzeczywistość badań naukowych. Impulsem do skomentowania był post Hanny Źródłowskiej.
Jeśli chodzi o to, żeby sprawdzić, jak AI zachowa się w konkretnej sytuacji, to generowanie innym-AI kontrolowanych rozmówców i konfrontowanie ich ze sobą jest jak najbardziej w porządku. To piękne wykorzystanie skalowania, w dodatku wiarygodne, bo np. klinicysta może przeczytać odpowiedzi AI i wskazać te, które mogą pogłębiać objawy paranoi.
Gorzej, kiedy na tej samej podstawie wyciąga się wnioski o człowieku. Że przy takich a takich odpowiedziach AI człowiek zachowa się tak a tak, albo że relacja z AI wpływa w określony sposób na jego rozwój. Nie kupuję tego.
LLM nie odwzorowuje wiernie realnego człowieka, a literatura pokazuje to dobitnie.
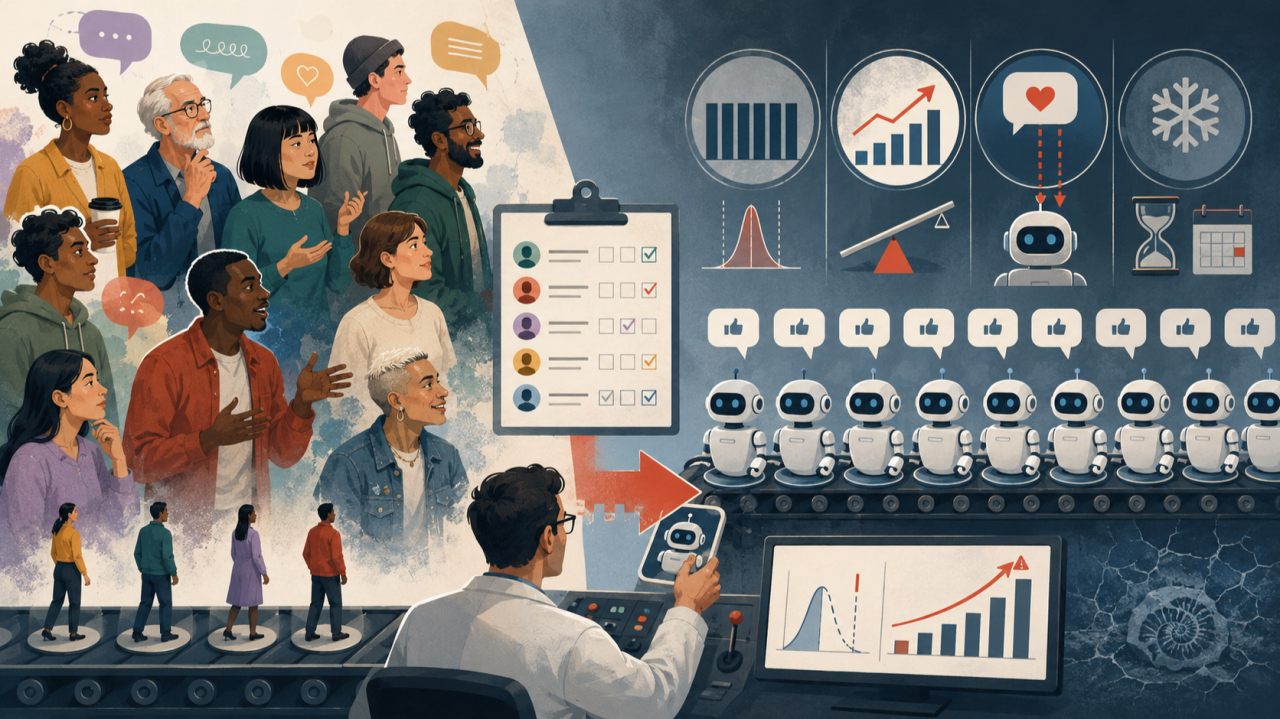
Wariancja
Bisbee [1] pokazał, że średnie z modelu potrafią wyglądać sensownie, ale rozkłady są sztucznie ściśnięte i model nie oddaje realnej różnorodności ludzi. Boelaert [2] nazwał to wprost machine bias, czyli silne obciążenie przy zaniżonej wariancji, gdzie kierunek obciążenia zmienia się losowo z tematu na temat. To samo widać u Argyle’a [3]: średnie zbliżone do danych ludzkich, wariancja zaniżona.
Skrzywienie
48% współczynników regresji istotnie różni się od ludzkich, a wśród nich znak efektu odwraca się w około 32% (Bisbee). Cui [4] pokazał, że modele zawyżają siłę efektów od dwóch do trzech razy i produkują od 68 do 83% fałszywych pozytywów tam, gdzie realnie żadnego efektu nie ma. Do tego dochodzi obciążenie samą treścią opinii. Santurkar [5] udokumentował wyraźne przechylenie w stronę lewicowo-liberalną i słabą reprezentację podgrup, a von der Heyde [6] na danych niemieckich pokazała, że model myli się systematycznie i kierunkowo, przeszacowuje Zielonych i Lewicę, a niedoszacowuje AfD, i wypada gorzej niż prostsze modele statystyczne (uczciwie trzeba zauważyć, że von der Heyde użyła antycznego GPT 3.5). To już nie szum, a systematyczny błąd.
Efekt oczekiwań badacza
Jeśli badany, często nieświadomie, jest w stanie odczytać, jakiej reakcji się od niego oczekuje, to LLM ma ten mechanizm podkręcony. Sharma [8] pokazał na pięciu czołowych asystentach, że modele systematycznie dopasowują odpowiedź do domniemanych poglądów rozmówcy. Westwood [7] poszedł dalej i pokazał, że bot ankietowy potrafi wprost zgadnąć hipotezę badacza i konsekwentnie ją potwierdzać. Czyli symulowany „pacjent” nie zachowa się jak realny człowiek, tylko odczyta scenerię eksperymentu i odda odpowiedź, której się od niego spodziewamy, co sztucznie napompuje każdy efekt, którego szukamy.
Brak zmienności w czasie
Model jest wytrenowany na zamrożonym wycinku świata. Ma jakiś dostęp do najnowszych informacji, całkiem swobodny, ale to nie to samo co życie w bieżącej rzeczywistości. Ludzie zmieniają opinie i zachowania w czasie, reagują na wydarzenia, mody i kryzysy. Model odtwarza rozkład z momentu treningu, więc z definicji nie łapie trendów, które właśnie się dzieją. Symulowany panelista jest więc nie tylko ściśnięty i skrzywiony, ale też przeterminowany.
Dlatego symulowanie jednego AI drugim po to, żeby badać AI, jest sensowne i sprawdzalne. Ale przeskok do „więc człowiek zrobi to samo” albo „więc relacja z AI ukształtuje człowieka w ten sposób” nie ma podstaw, bo ten symulowany człowiek to nie człowiek, tylko jego ściśnięty, skrzywiony i przeterminowany cień.
Źródła
- Bisbee i in., Synthetic Replacements for Human Survey Data? The Perils of Large Language Models. https://doi.org/10.1017/pan.2024.5
- Boelaert i in., Machine Bias. How Do Generative Language Models Answer Opinion Polls? https://doi.org/10.1177/00491241251330582
- Argyle i in., Out of One, Many: Using Language Models to Simulate Human Samples. https://doi.org/10.1017/pan.2023.2
- Cui i in., A large-scale replication of scenario-based experiments in psychology and management using large language models. https://doi.org/10.1038/s43588-025-00840-7
- Santurkar i in., Whose Opinions Do Language Models Reflect? https://arxiv.org/abs/2303.17548
- von der Heyde i in., Vox Populi, Vox AI? Using Large Language Models to Estimate German Vote Choice. https://doi.org/10.1177/08944393251337014
- Westwood, The potential existential threat of large language models to online survey research. https://doi.org/10.1073/pnas.2518075122
- Sharma i in., Towards Understanding Sycophancy in Language Models. https://arxiv.org/abs/2310.13548